内容生成的门槛快速下降,验证成为新瓶颈
10 月 1 日,Google 的漏洞赏金官方账号发了一条公告,关键词只有五个字:绝大多数无效。从这一天起,开源软件漏洞奖励计划(OSS VRP)停止接收产品漏洞提交。 同一天,arXiv 宣布:每位提交者每个自然月最多投 2 篇论文。一个是全球最大的开源安全激励计划,一个是全球最大的预印本平台,同...
10 月 1 日,Google 的漏洞赏金官方账号发了一条公告,关键词只有五个字:绝大多数无效。从这一天起,开源软件漏洞奖励计划(OSS VRP)停止接收产品漏洞提交。
同一天,arXiv 宣布:每位提交者每个自然月最多投 2 篇论文。一个是全球最大的开源安全激励计划,一个是全球最大的预印本平台,同日关门。
把时间往前拨。6 月,NeurIPS 用 AI 检测工具扫了 969 篇投稿,直接拒掉 178 篇,占 18.4%。官方博客给出的理由不是「学术不端」,而是一句更冷静的话:把 AI 生成的文本交给同行评审,等于把核查的成本转嫁给审稿人。
4 月,《纽约时报》报道了一家金融服务公司:引入 AI 编程工具后,月产代码从 2.5 万行涨到 25 万行,积压待审的代码约 100 万行。
四个现场,三个行业,看起来毫不相干。真正发生的事只有一件——**AI 把「生成」的边际成本压到接近零,却没有降低「验证」的成本。**约束条件于是从生成搬到了验证。而几乎所有现行机制,都是按生成量定价的。
两道工序,一道在塌,一道没动
生成和验证,是整个知识生产流程的两道工序。
生成一份「看起来像样」的东西——一段代码、一篇论文、一份漏洞报告——过去本身就是一道过滤器。它贵,所以把不认真的人挡在外面。
大模型把这道理序压到了几分钟。
验证没有变便宜。代码要有人读、要跑测试、要判断架构有没有被悄悄改坏;论文要有人读、要复现、要辨真假;漏洞报告要有人读、要试着复现、要判定再关闭。每一份产出,不论真假,都得由人过一遍。
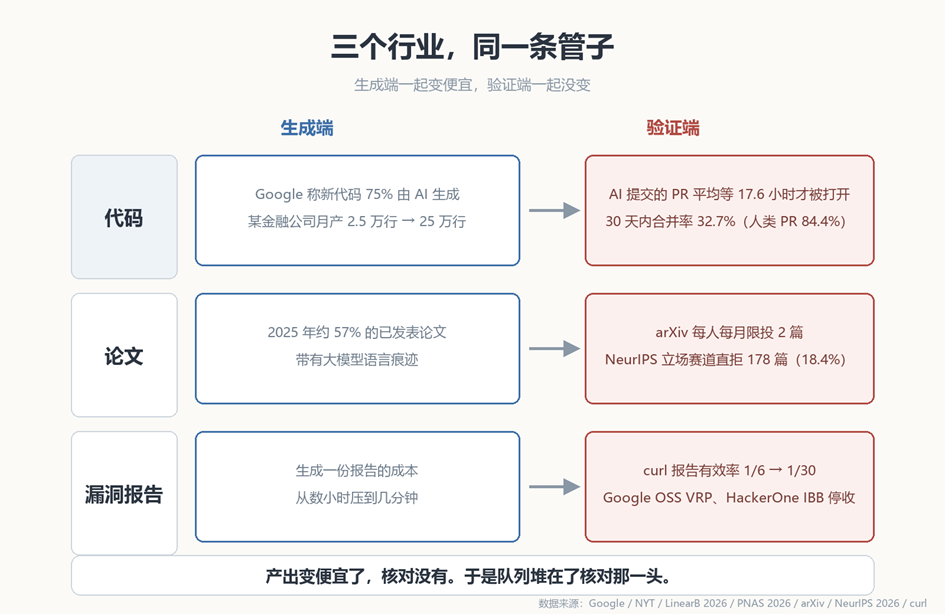
入口的成本趋近于零,出口的成本原地不动,中间那一段就被撑爆了。三个行业各自的具体账:
| 领域 | 生成端 | 验证端 |
|---|---|---|
| 代码 | Google 称新代码 75% 由 AI 生成(2026 年 4 月);某金融公司月产代码从 2.5 万行到 25 万行 | agent 提交的 PR 平均等 17.6 小时才被打开(人类 PR 为 3.4 小时);30 天内合并率 32.7%(人类 PR 84.4%) |
| 论文 | 2025 年约 57% 的已发表论文带有大模型语言痕迹(2023 年为 12%) | arXiv 每月限投 2 篇;NeurIPS 立场赛道直拒 178 篇(18.4%);ICLR 2026 约 21% 的评审完全由 AI 生成 |
| 漏洞报告 | 生成成本从数小时压到几分钟 | curl 报告有效率从约 1/6 掉到 1/20–1/30;HackerOne「互联网漏洞赏金」停收;Google OSS VRP 停收 |
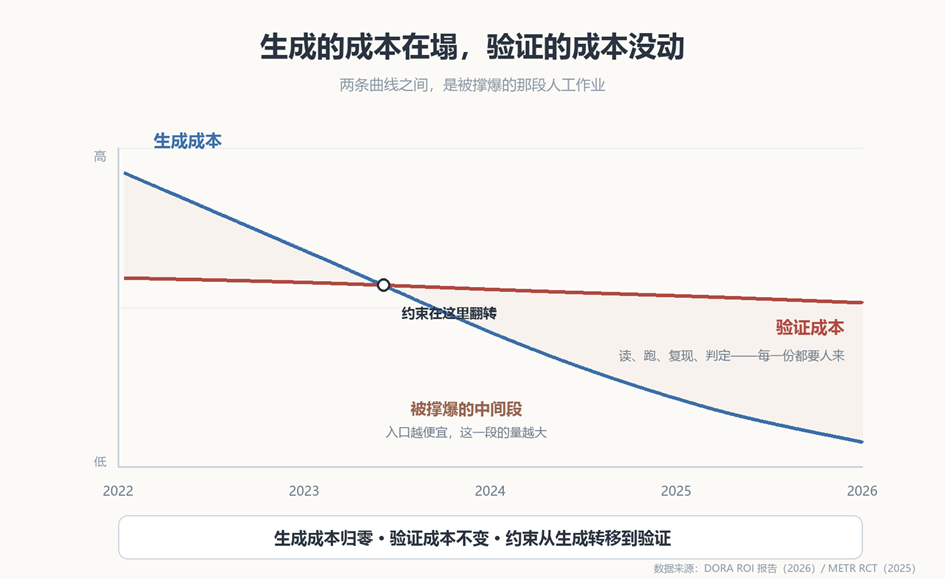
生成成本与验证成本,正在拉成一把剪刀
验证税:连最乐观的一方也把它单列了
给这件事命名的,是 DORA——Google Cloud 旗下研究软件交付的团队。在 2026 年的 ROI 报告里,它把「为了确认 AI 产出是否正确、安全、符合系统架构而多付出的工」叫做 verification tax,验证税。
DORA 把 AI 落地画成一条 J 形曲线:先掉下去,再涨上来。掉下去那段由三样东西构成——学习成本、下游流程改造,以及这项验证税。报告管它叫「转型的学费」,并提醒管理者别把第一季度的下滑当成失败。
报告给了两组数字。简单的新建项目上,AI 带来约 35%–40% 的效率提升;复杂的存量代码上,不到 10%。它那个 500 人工程组织的示例模型里,引入 AI 后变更失败率从 5% 升到 6%,折算出约 34.4 万美元的停机损失。
这份报告本身是乐观的:第一年 39% 的 ROI、8 个月回本,并明确建议企业不要靠裁员兑现收益。正因为乐观,那句「生成便宜了、检查没有」才更站得住——连最看好 AI 的一方,也把这条成本单独列了出来。
另一组证据来自反面。METR 做过一次随机对照实验:16 位资深开源开发者,在自己的项目上完成 246 个真实任务,随机决定哪一半可以用 AI。结果是用了 AI 的那一半平均慢了 19%。但开发者自己觉得快了 20%,事前他们的预测是快 24%。
结论不是「AI 没用」,而是:人对验证成本几乎没有感知。
谁受益,谁受损,谁被漏掉
先说受益的一方,而且必须说清楚:AI 确实在真干活,这一点不该被这轮新闻盖住。
curl 负责人 Daniel Stenberg 说,团队跑的 AI 分析工具帮他修掉了 100 多个真 bug。其中一个是 Telnet 实现里某个字节不符合一份 2012 年后再没人读过的规范。他在自己的 PR 上挂了三个 AI 审查机器人,让它们凌晨两点替他找问题。
受损的第一类人是开源维护者:验证成本落在他们身上,而且大多无偿。第二类是合规的独立研究者——门一关,真问题和假问题一起被挡在外面。
被漏掉的那一方是修复。HackerOne 的「互联网漏洞赏金」从 2012 年起采用 80/20 分账:80% 的奖金给发现问题的人,20% 给负责修复的开源项目。这套设计的前提是「发现比修复难」。AI 把这个前提掀翻了——发现变便宜,修复没有。所以停掉的是发现侧。公告里那句「确保漏洞发现能转化为持久的修复结果」,翻译过来就是:钱付错了地方。
代价顺着链条往下传。IBB 一停,Node.js 的赏金资金被切断,4 月起提交流程不变、奖金归零。
一个细节值得单独看:验证工具也需要被验证
NeurIPS 那 178 篇直接拒稿引起了争议,原因不在结论,在方法。
检测工具用默认窗口(250–350 词)跑时,判定为「高度疑似 AI 生成」的稿件占 28.2%。换成 100 词的窄窗口,同一批稿件的比例掉到 12.7%。一个对作者完全不可见的参数,决定了 18.4% 的拒稿率。
用自动化去堵验证的缺口,本身又欠了一次人工验证。
还有一层更硬的限制:AI 审 AI 有共盲区。两个同源的模型会犯同一种错,让它们互相检查,得到的是「同一个意见说了两遍」,而不是一次独立复核。所以如今能自动化的,大多还是排序、查重、溯源这类机械工序。「这份东西到底对不对」,仍然没有便宜的答案。
判断:不是 AI 写得太快,是评价方式没跟上
这一轮的问题不是 AI 太能生成,而是所有按生成量计价的机制,在同一时间到期了。
漏洞赏金按「发现」付钱,论文按「产出」计量,代码效率按「行数」和「PR 数」汇报。三套计价方式共享同一个假设:生成是稀缺的。这个假设在 2025 年到 2026 年之间塌了,评价方式没跟上。
这不是五家机构各自的管理失误,是同一个结构性错配在三个行业同时到期。
curl 给出了这套账最清楚的一版数字。2026 年 1 月,Stenberg 关掉了运行七年的漏洞赏金计划。触发点很具体:某一周,16 小时之内收到 7 份报告,没有一份指出安全漏洞。更值得看的是有效性——到 2025 年初,curl 的安全报告里大约每 6 份有 1 份是真的;到 2025 年底,掉到了 1/20 到 1/30。
对做产品的人,该记住的就是这个比例。当入口成本降到零、而承接的人没变,信噪比就会掉到 1/30。 这跟你在做安全、做客服、做招聘还是做供应商审核,没有关系。